Opis wyników regresji zaczyna się od pytania, co oznacza jeden współczynnik w konkretnym modelu. Potrzebujesz nazw zmiennych, jednostek, sposobu kodowania i informacji o niepewności. Poniżej przełożysz gotowy wynik regresji liniowej na akapit, który odpowiada na pytanie badawcze, zachowując granicę między związkiem statystycznym a przyczyną.
Przeczytaj specyfikację, zanim wybierzesz liczby
Ustal, co model opisuje: wynik punktowy, czas czy inną wielkość. Sprawdź predyktory, transformacje, kategorię odniesienia i obecność interakcji. Współczynnik ma sens razem z tym opisem. Liczba 2 może oznaczać punkty na godzinę, inną jednostkę albo parametr w przekształconym modelu. Nie interpretuj jej według samego wyglądu wydruku.
Ten poradnik dotyczy opisu istniejącej regresji liniowej ze stałą, dwoma predyktorami i bez interakcji. Nie jest instrukcją wyboru modelu. W rzeczywistym raporcie odszukaj ocenę jego założeń: między innymi liniowej postaci zależności, niezależności błędów oraz warunków uzasadniających podane błędy standardowe i testy. Same współczynniki nie dokumentują tej kontroli.
Sprawdź liczbę rekordów użytych w modelu. Gdy z większej bazy wyłączono przypadki z brakami, N w opisie regresji powinno odpowiadać analizie, a nie wszystkim zebranym ankietom. Powód i sposób wyłączenia także należą do dokumentacji wyniku.
Rozpoznaj zmienne w demonstracyjnym raporcie
Cały materiał poniżej jest fikcyjny i został skonstruowany do ćwiczenia. Odtworzono arytmetykę regresji na 40 syntetycznych rekordach. Nie są to wyniki rzeczywistego badania ani empiryczny dowód spełnienia założeń modelu. Wnioskowanie w przykładzie pokazujemy warunkowo, przy założeniu poprawności klasycznego modelu.
- Zmienna objaśniana: wynik umownego sprawdzianu w punktach.
- Pierwszy predyktor: deklarowany tygodniowy czas samodzielnej nauki w godzinach, od 1 do 10.
- Drugi predyktor: udział w warsztacie, kod 0 oznacza brak udziału, a 1 udział. Każda grupa liczy 20 rekordów.
- Model: wynik punktowy = stała + B dla godzin × godziny + B dla udziału × kod udziału. Oszacowana stała wynosi 30,00.
Dwa predyktory i stała oznaczają trzy oszacowane parametry. Dla 40 kompletnych rekordów pozostaje 37 stopni swobody reszt. W przykładzie nie ma wag, braków ani dodatkowych zmiennych ukrytych pod określeniem „model skorygowany”.
- Współczynnik niestandaryzowany
- B = 2,00 punktu na godzinę.
- Niepewność oszacowania
- SE = 0,233; 95% CI od 1,53 do 2,47 punktu na godzinę.
- Test dwustronny wobec B = 0
- t(37) = 8,58; p < 0,001.
- Porównanie i współczynnik
- Udział wobec braku udziału: B = 4,00 punktu.
- Niepewność oszacowania
- SE = 1,340; 95% CI od 1,29 do 6,71 punktu.
- Test dwustronny wobec B = 0
- t(37) = 2,99; p = 0,005.
Zamień współczynnik na zdanie z jednostką
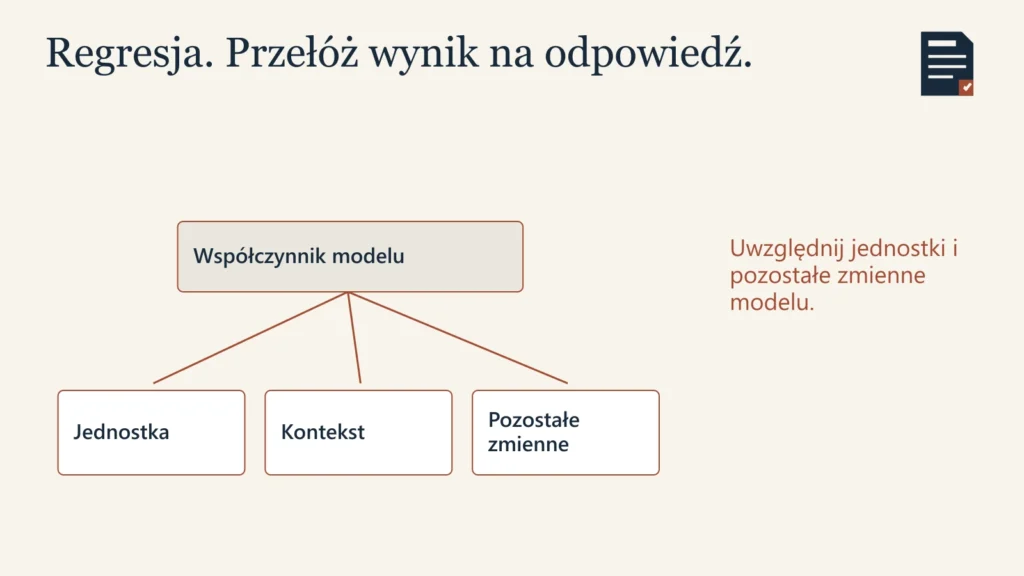
W tym modelu B = 2,00 oznacza, że przy takim samym zakodowanym statusie udziału w warsztacie różnicy jednej godziny nauki odpowiada różnica 2,00 punktu w przewidywanej średniej wyniku. Przykładowo model wyznacza dla osoby bez udziału w warsztacie 40 punktów przy pięciu godzinach i 42 przy sześciu. To odczyt funkcji regresji, nie obietnica wyniku konkretnej osoby.
Współczynnik udziału porównuje kod 1 z kategorią odniesienia 0 przy tej samej liczbie godzin. Przewidywana średnia jest w modelu wyższa o 4,00 punkty dla udziału. Po odwróceniu kodowania zmieniłby się sens porównania i znak odpowiedniego współczynnika. Dlatego nazwa kategorii odniesienia powinna pozostać w opisie.
Nie zamieniaj tych zdań na „każda dodatkowa godzina powoduje wzrost wyniku” albo „warsztat poprawił wynik o cztery punkty”. Uwzględnienie drugiej zmiennej nie usuwa wszystkich możliwych różnic między osobami. Skorygowany związek nadal wymaga ostrożnej interpretacji. Przyczyna wymaga uzasadnienia wykraczającego poza sam współczynnik.
W tym poradniku B oznacza współczynnik niestandaryzowany. Standaryzowana beta posługuje się jednostkami odchyleń standardowych i nie może zostać odczytana jako punkty na godzinę. Sprawdź legendę własnego raportu. Stała 30,00 jest matematycznym punktem odniesienia przy zerze godzin i kodzie 0; zero godzin znajduje się poza zakresem naszego przykładu. Nie przedstawiaj stałej jako zaobserwowanego wyniku takiej osoby.
Połącz wynik w sprawdzalny akapit
„W demonstracyjnej regresji liniowej obejmującej 40 kompletnych rekordów wyższy deklarowany czas samodzielnej nauki wiązał się z wyższą przewidywaną średnią wyniku sprawdzianu przy uwzględnieniu udziału w warsztacie: B = 2,00 punktu na godzinę, 95% CI [1,53; 2,47], t(37) = 8,58, p < 0,001. Przy tej samej liczbie godzin udział w warsztacie, w porównaniu z jego brakiem, wiązał się z różnicą 4,00 punktu, 95% CI [1,29; 6,71], p = 0,005. Model zawierał stałą i nie uwzględniał interakcji”.
W pracy dodaj odwołanie do pełnego zestawienia. Jeśli właściwy model ma interakcję, ten akapit nie jest gotowym wzorem do podmiany nazw: znaczenie jednego współczynnika może zależeć wtedy od wartości innego predyktora.
Oddziel dopasowanie od jakości przewidywania
W przykładzie R² wynosi 0,690, a skorygowane R² 0,674. Model ujmuje około 69% zróżnicowania wyniku punktowego w tym syntetycznym zbiorze. Nie oznacza to 69% poprawnie przewidzianych osób, 69% skuteczności warsztatu ani potwierdzonej trafności na nowych danych. Skorygowane R² uwzględnia liczbę oszacowanych parametrów, ale także nie zastępuje walidacji przewidywania.
95% przedział dla B dotyczy oszacowania współczynnika przy przyjętych założeniach. Nie jest przedziałem wyniku przyszłego uczestnika. Dokumentacja R rozróżnia przedziały parametrów, średniej odpowiedzi i pojedynczej przyszłej obserwacji. Nie zamieniaj ich nazw w redakcji. Małe p również nie określa znaczenia praktycznego różnicy, co podkreśla stanowisko ASA.
Sprawdź pięć elementów przed oddaniem
- Porównaj N i listę zmiennych z dokładnie tym modelem, którego współczynniki opisujesz.
- Zachowaj jednostkę B, kategorię odniesienia i informację o ewentualnych interakcjach.
- Przepisz SE, p i przedział z tej samej analizy oraz właściwego wariantu oszacowania niepewności.
- Nie przedstawiaj dopasowania w próbie jako sprawdzenia nowych przewidywań.
- Usuń twierdzenie przyczynowe, jeśli projekt i analiza nie dostarczają jego uzasadnienia.
Przełóż gotowy model na czytelny opis
Usługa „Opracowanie rozdziału wyników” może objąć opis istniejącego raportu i powiązanie współczynników z pytaniem badawczym. Przygotuj specyfikację modelu, pełny output, objaśnienia jednostek i kodowania, informację o brakach oraz kontroli założeń i obecny fragment rozdziału. Usuń zbędne dane identyfikujące uczestników. Ponowne obliczenia lub weryfikacja doboru modelu wymagają odrębnego uzgodnienia.